2026-08-20 · 재성 허 · 57
sqld
SQLD 알짜 노트
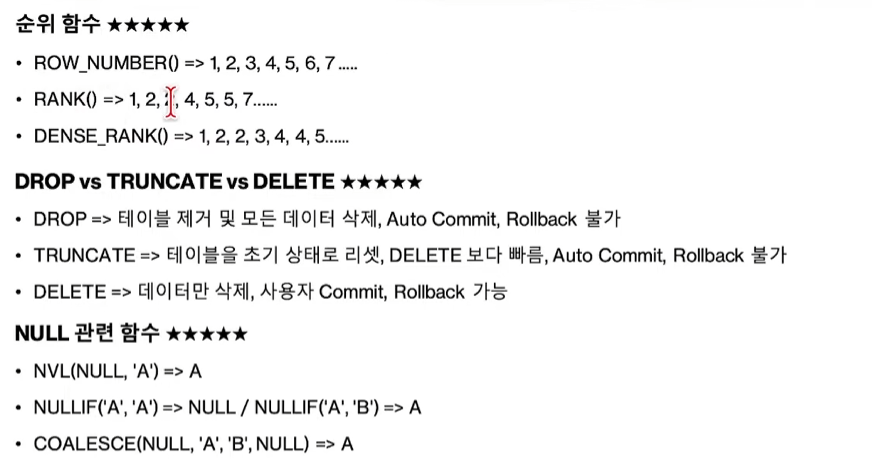
NVL2('A','B','C') => 'A'가 NULL이면 C 아니면 B
PIVOT/UNPIVOT
- PIVOT = 행을 열로 (세로 → 가로).
- UNPIVOT = 열을 행으로 (가로 → 세로, PIVOT 반대).
주의: UNPIVOT은 NULL인 셀은 기본적으로 결과에서 빠짐. - 암기 포인트: PIVOT엔 집계함수 필수, FOR ~ IN 세트로 다님.
PIVOT 예시
SELECT * FROM 매출
PIVOT (SUM(금액) FOR 상품 IN ('A' AS A, 'B' AS B));
| 지역 | A | B |
|---|---|---|
| 서울 | 100 | 200 |
| 부산 | 150 | NULL |
SUM(금액) = 집계 함수 (PIVOT엔 필수)
FOR 상품 = 어떤 컬럼 값을 열로 펼칠지
IN ('A', 'B') = 열로 만들 값들 (여기 나열한 것만 열이 됨)
(+) Oracle 전용 외부 조인
(+)는 오라클 옛날식 OUTER JOIN 표기.
NULL을 채워줄(=부족한) 쪽에 (+)를 붙힌다.
-- 표준 문법
SELECT * FROM 사원 e LEFT OUTER JOIN 부서 d ON e.부서id = d.id;

-- 오라클 (+) 방식 (같은 결과)
SELECT * FROM 사원 e, 부서 d WHERE e.부서id = d.id(+);
핵심 : (+)는 부족한 쪽에 붙는다 = 데이터 없어서 NULL로 채워질 쪽.
위 예시: 사원은 다 나오고 부서가 없으면 NULL → 부서 쪽(d.id)에 (+)
- 함정: (+)를 왼쪽에 붙이면 결과가 반대(오른쪽 테이블 기준)가 됨
- 주의: 한 쿼리에서 양쪽에 동시에 (+) 못 붐 (FULL OUTER는 (+)로 불가)
헷갈리면: "(+) = 이쪽이 부족하니 채워라" 로 외우기.
LEAD / LAG
윈도우 함수 — 앞뒤 행 값을 끌어옴.

LAG = 이전 행 (뒤에 있는 거 끌어옴, 과거)
LEAD = 다음 행 (앞에 있는 거 끌어옴, 미래)
윈도우 함수 — 앞뒤 행 값을 끌어옴.
LAG = 이전 행 (뒤에 있는 거 끌어옴, 과거)
LEAD = 다음 행 (앞에 있는 거 끌어옴, 미래)
| 날짜 | 매출 | 전일매출 | 익일매출 |
|---|---|---|---|
| 1일 | 100 | NULL | 200 |
| 2일 | 200 | 100 | 150 |
| 3일 | 150 | 200 | NULL |
문법: LAG(컬럼, 몇칸, 없을때기본값) OVER (ORDER BY ...)
2번째 인자 생략하면 기본 1칸, 3번째 생략하면 NULL
맨 앞 행의 LAG, 맨 뒤 행의 LEAD는 NULL
L-A-G → 과거(뒤), L-E-A-D → 미래(앞, 리드=앞서간다) 로 방향 잡기.
UNBOUNDED — 윈도우 범위 지정
집계 윈도우 함수에서 "어디부터 어디까지" 범위를 정할 때 쓰는 키워드
SUM(금액) OVER (ORDER BY 날짜
  ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)
키워드 뜻:
- UNBOUNDED PRECEDING = 맨 처음 행부터
- UNBOUNDED FOLLOWING = 맨 마지막 행까지
- CURRENT ROW = 현재 행
범위 의미
- UNBOUNDED PRECEDING ~ CURRENT ROW 처음부터 현재까지 (누적합)
- CURRENT ROW ~ UNBOUNDED FOLLOWING 현재부터 끝까지
- UNBOUNDED PRECEDING ~ UNBOUNDED FOLLOWING 전체 (그룹 총합)
UNBOUNDED = "끝까지 무제한" (경계 없음). PRECEDING=앞쪽, FOLLOWING=뒤쪽.
- 누적합 문제 나오면 UNBOUNDED PRECEDING AND CURRENT ROW 거의 정답.
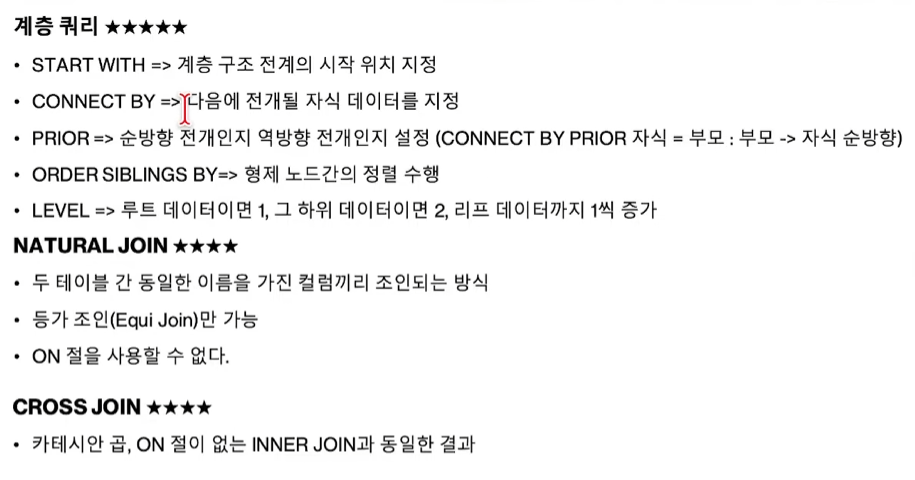
계층 쿼리 (Hierarchical Query)
트리 구조(조직도, 카테고리 등)를 파고드는 오라클 문법. 사원-관리자 관계가 대표 예시.
SELECT 사원명, LEVEL
FROM 사원
START WITH 관리자id IS NULL        -- 최상위(루트)부터 시작
CONNECT BY PRIOR 사원id = 관리자id  -- 부모-자식 연결 규칙
ORDER SIBLINGS BY 사원명;
핵심 요소:
-
START WITH = 시작점(루트) 지정. 관리자id IS NULL = 맨 위 사장
-
CONNECT BY = 부모↔자식 연결 조건
-
PRIOR = "이전(부모) 행"을 가리킴. PRIOR 위치가 방향을 결정
-
PRIOR 사원id = 관리자id → 위에서 아래로 (정방향, 부모→자식)
-
사원id = PRIOR 관리자id → 아래에서 위로 (역방향)
-
LEVEL = 계층 깊이 (루트=1, 그 아래=2...). 의사 컬럼이라 SELECT에 바로 쓸 수 있음
-
CONNECT_BY_ROOT = 최상위 루트 값, SYS_CONNECT_BY_PATH = 경로 전체 문자열
-
함정 1: PRIOR가 어느 쪽에 붙었냐로 방향(순방향/역방향)이 갈림 → 시험 단골
-
함정 2: LEVEL은 START WITH부터 셈. 루트가 무조건 1.
그 밖의 꿀팁 필독 !!!!!
-
Where,having,GROUP BY 에는 SELECT 별칭을 못 쓴다.
-
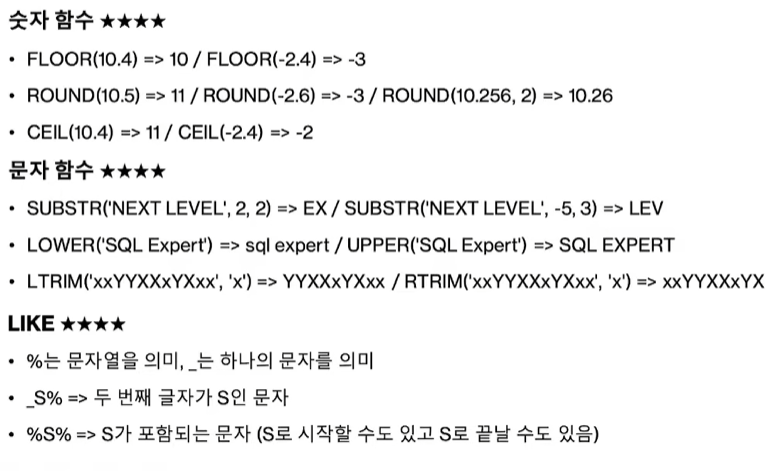
그냥 TRIM은 무조건 FROM이랑 같이 써야함 LTRIM, RTRIM이랑 다름. Trim(…from..)
-
REPLACE는 3번째 인자 없으면 2번째 인자를 빈 문자열로 치환함.
-
\w 가 나오면 이건 문자 클래스임 [A-Z,a-z,0-9_]
-> (\w 관련 문제인데, 문자열에 '-' 이딴거 붙어있으면 그냥 오답임) -
^ 이건 문자 시작임
-
' 은 문자열 시작 끝이라 출력에서 제외됨 (''A'''' -> 'A''' 로 여겨짐)
-
'' <- 두개 붙으면 '로 치환됨 ('''A'''''' -> 첫/끝 제외 -> ''A''''' -> '' 치환 -> 'A'''
-
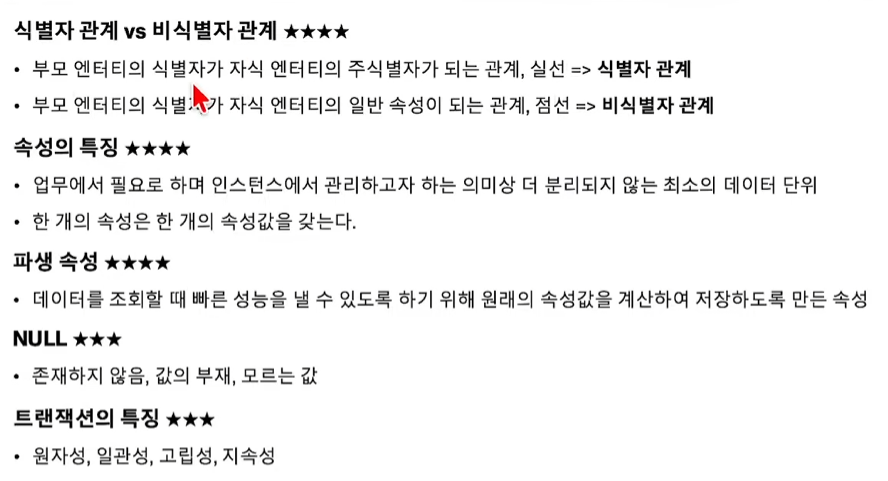
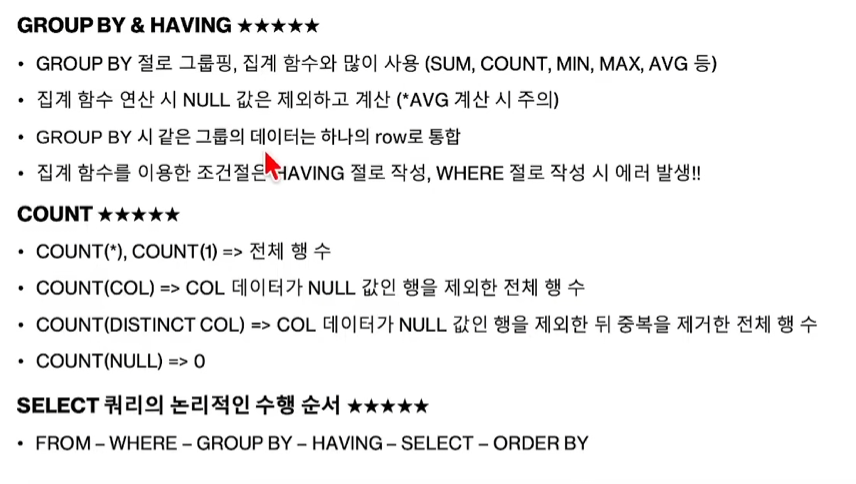
COUNT는 절대 출력이 NULL이 될 수 없고 0이됨 (단골 문제)
-> MAX(), SUM(), AVG() 등은 대상 행이 하나도 없거나 전부 NULL이면 결과가 NULL이 됨. -
SUM과 같은 집계함수에서 NULL+5는 NULL이 아니라 NULL을 제외하고 더함
-
CROSS JOIN 나오면 그냥 행수x행수
-
[0-9]{4} 이딴거 나오면 "ahdfs-905040" 일때 숫자 해당하는거 발견되는 시점 부터 4개 찍는다 이런말.
만약에 {2,4}면 최소한 숫자가 두개가 나와야하고 최대 4개까지 반복되면 된다는 말 (9a50405 라면 5040이 출력) -
다중행 서브쿼리는 여러 행을 반환하기 때문에 (=,<,>)과 같은 단일행 비교 연산자랑 같이 쓸 수 없음.
-
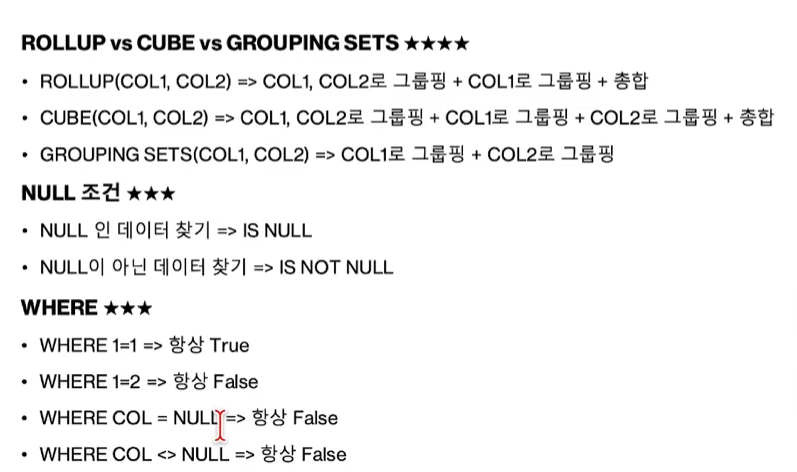
CUBE 연산 모르면 그냥 값 젤 많은거 고르셈
-
NATURE JOIN은 ON, USING 이딴거랑 같이 못 씀 (조건 자동으로 걸어줘서)
-
CHECK(...)는 UNKNOWN을 위반으로 안보기 때문에 입력이 성공됨 (입력 결과 나머지 셋과 다른경우의 문제에 자주 출몰)
-
오름차순이면 NULL 값들이 최하위로, 내림차순이면 NULL 값들을 최상위로.
-
GROUPING은 반환값이 0또는 1만 반환
-> 소계/합계 되어서 생긴 컬럼값이 NULL이면 1
-> 컬럼 값이 그룹화하는데 실제로 참여되면 0 -
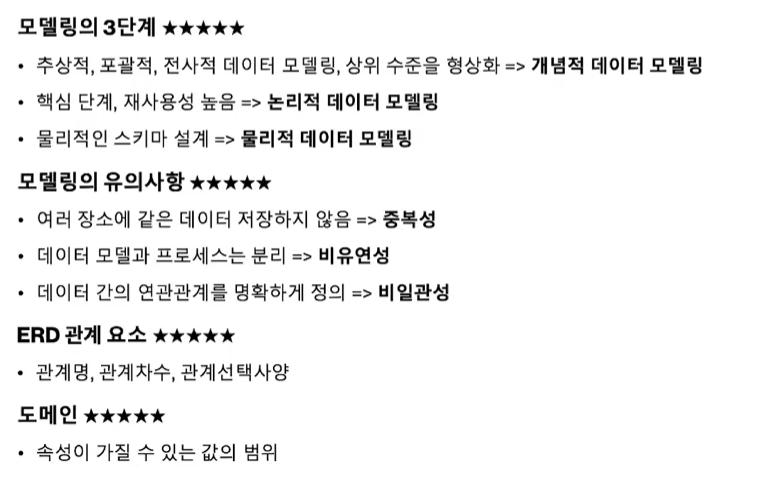
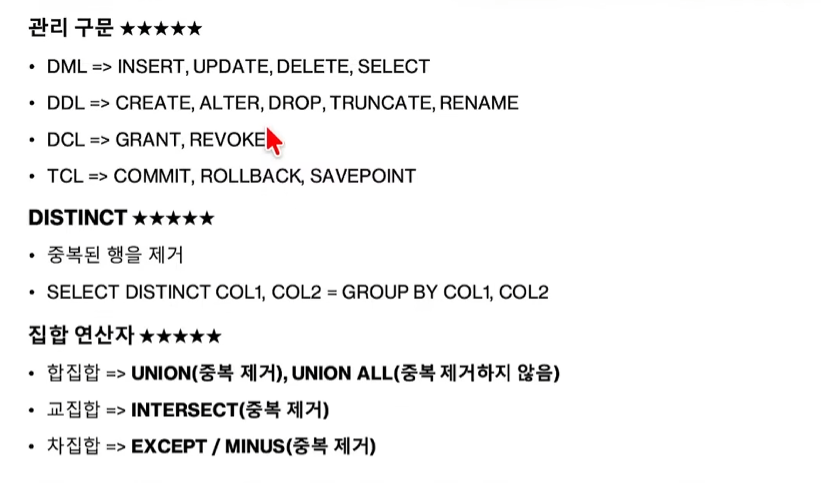
UNION 중복 따짐, UNION ALL 중복 안따짐
-
LEVEL은 1부터 시작함
-
뷰나오면 테이블 삭제하면 뷰도 삭제되냐 & 물리냐 논리냐 따지는 문제가 나오는데 (가상 테이블이므로 논리이고 테이블 삭제되면 뷰부터 삭제됨)
-
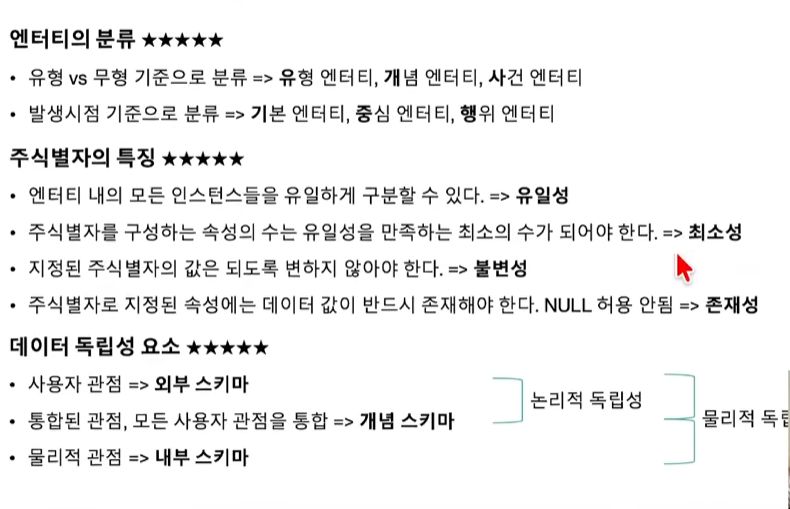
주식별자나오면 오로지 한 집에만 있는 놈, 비식별자는 다른 곳에 놀러가있는 컬럼값인 놈
-
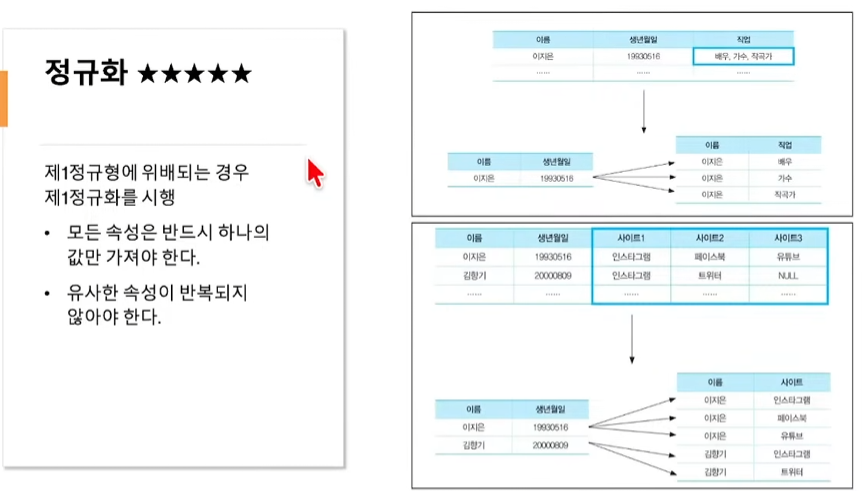
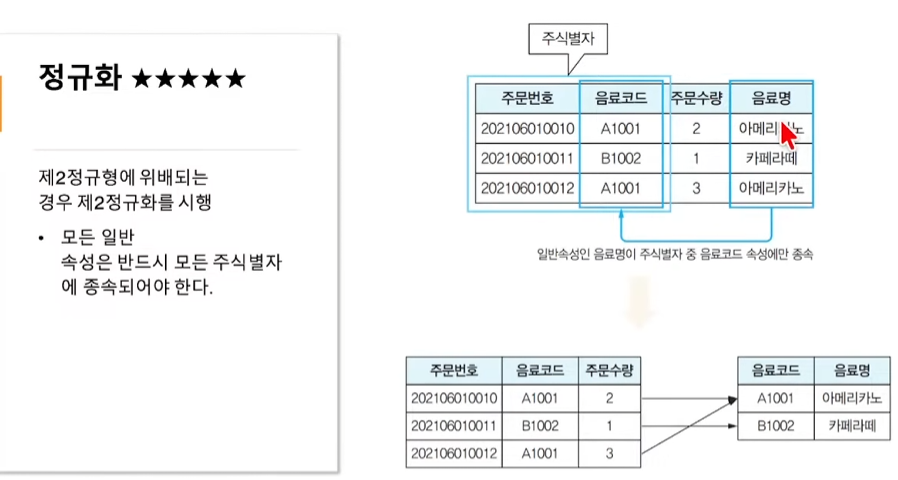
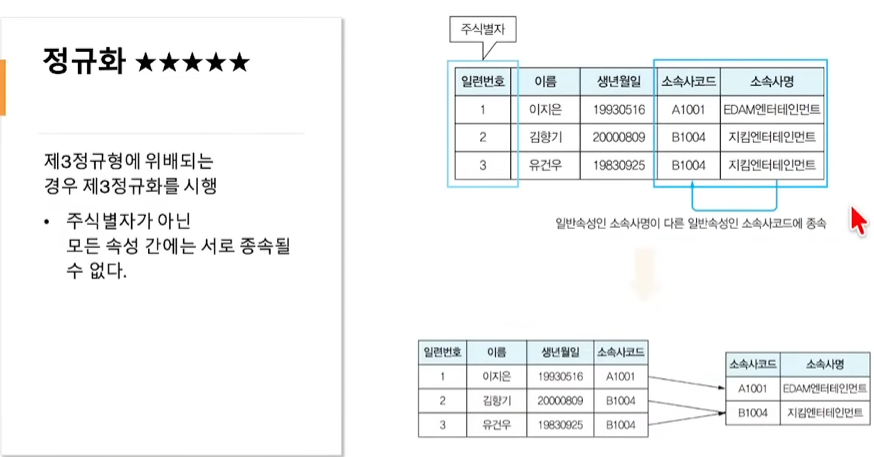
부분적 함수 : 2정규화, 이행적 함수 : 3정규화
-
FIRST_VALUE 나오면 그냥 첫번째 값으로 다 반환된다
-> 1000,2000,3000 으로 정렬된 상태라면 1000,1000,1000으로 나옴 -
(+) 붙으면 붙은 놈 날려버린다 생각
-> (+) 붙은놈한테 JOIN을 한다이런거 말이 안됨. -
서브쿼리에 대해 두 값 이상 반환한다거나, 유일성을 따진다거나 할때 제약조건 물어보면 UNIQUE제약조건
-
RESTRICT 나오면 참조된 조건 있을 때 삭제 거부 (뷰-테이블 삭제 낚시 문제로 많이 나옴)
-> 사원번호가 사원을 참조하는 View일때 사원 테이블을 삭제하면?
DROP TABLE 사원 RESTRICT -> 아무것도 삭제 안됨. -
NULL과의 사칙연산은 전부 NULL임
-
대표성 가진다 = 주식별자, 대표성 없다 = 보조식별자, 업무적 키워드가 있다 = 본질식별자, 상속 키워드 있다 = 외부 식별자 , 인조적뭐시기 키워드가 있다 = 인조식별자
-
ORDER BY n : SELECT 절에서 n번째 컬럼으로 정렬
-
ORDER BY 컬럼1,컬럼2 면 컬럼1로 정렬 후 컬럼2로 정렬
-> 주의점 컬럼1로 정렬된 후 컬럼2값들 내에서만 정렬해야함 -
ORDER BY 절에 사용할 수 있는 일반 컬럼은 반드시 GROUP BY 절에 명시된 컬럼이어야함.
-
SQL 작성 시 NOT->AND->OR 순으로 배치되어야함.
-
ROUND에 날짜가 나오면? 16일 이상이면 다음달 1일로 반올림.
-> 시간 나오면? 30초, 30분 단위로 따져서 반올림.
-> 월만..은 안나오겠지만 6월이상으로 따져서 년수 올림
-> -2가 나오면 백의자리, -1 십의 자리 반올림 : ROUND(150.756,-2) -> 200 -
1/24 : 1시간 , 1/24/60 : 1분
-
DECODE 같은거 나오면 '=' 비교만 가능
-
UNION 사용 주의 사항
조회하는 컬럼 수가 모든 SELECT 문에서 동일해야 함
대응하는 컬럼의 데이터 타입이 상호 호환되어야 함
ORDER BY 구문은 맨 마지막 SELECT 문 뒤에만 1회 작성 가능
- 연산순서 : 괄호가 1등 -> 산술연산(+,-,*,/) -> 비교 연산 (=,<,>) -> 특수 연산(BETWEEN, IN, LIKE ..) -> 논리연산자 NOT -> AND -> OR
- RANK는 공동2등 후 다음 4등, DENSE_RANK는 공동2등 후 다음 3등 (단골문제)
- LIKE 틀리면 진짜 멍청이 _, % 잘 따져가기
- BETWEEN JOIN이란건 잘못된 문법임
- SQL 문 읽을 때는 침착하게 읽기 글 많다고 멘헤라 오면 안됨
-> 서브쿼리 먼저 -> FROM -> Where -> Grop by -> Select -> Orderby
다들 시험 잘 보세요 ^^
댓글 0
아직 댓글이 없습니다.
로그인 후 댓글을 남길 수 있어요