2026-08-18 · 재성 허 · 66
sqld
SQL 핵심함수
문자 인코딩
EUC-KR : 2Byte
UTF-8 : 3Byte
'가' 한글자 기준으로 LEGTH는 1, LENGTHB는 2 또는 3
- LEN() = LENGTH()
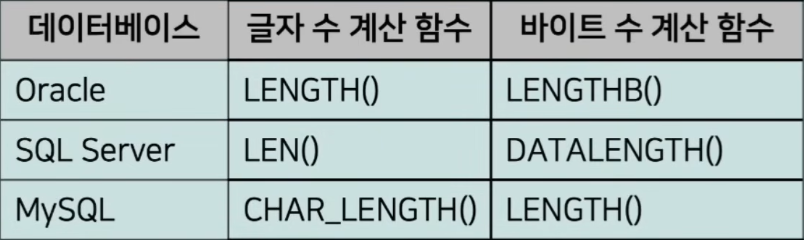
그래서 'B'가 붙으면 바이트! 이기 때문에, 글자 수가 아니라 바이트를 묻는 문제
문자열 공백
Ltrim("ㅁㅁSQL") -> "SQL" (왼쪽 공백 제거)
Rtrim("SQLㅁㅁ") -> "SQL" (오른쪽 공백 제거)
Trim("ㅁSQLㅁ") -> "SQL" (양쪽 공백 제거)
💡 Trim('#' from '##SQL##') -> "SQL"
문자열 자르기
SUBSTR : 문자열 중 몇 번째부터 몇 글자 뽑을지 직접 지정
SUBSTR('DATABASE',3,4)
INSTR : 문자열 안에서 특정 문자가 몇 번쨰에 있는지 알려줌.
INSTR('DATABASE','B') # 5
INSTR('DATABASE','A') # 2
INSTR('DATABASE','a') # 0
💡 SUBSTR('DATABASE,INSTR('DATABASE','T'),3) #TAB
SUBSTRING : SUBSTR과 동일
문자열 채우기
LPAD : 총길에 맞춰 오른쪽에 정렬하고 왼쪽에 남는 공간을 채울문자로 채움
RPAD : 총길에 맞춰 왼쪽에 정렬하고 오른쪽에 남는 공간을 채울문자로 채움
L/R PAD(문자열, 전체길이, 채울문자)
LPAD('SQL',8,'&') # &&&&&SQL' , 'SQL&&&&&'
문자열 결합 및 변환
CONCAT : 둘 이상의 문자열을 순서대로 합침
CONCAT(컬럼1, 컬럼2)
CONCAT(김미주, 님) # 김미주님
CONCAT(김미주,님) = SELECT '김미주' || '님'
ASCII : 문자의 아스키 코드 값을 숫자로 반환
SELECT ASCII('A') # 65
CHR/CHAR : 아스키 코드 값에 해당하는 문자를 반환
SELECT CHR(65) # "A"
문자열 치환
REPLACE :
010--5573-0354
REPLACE('010--5573-0354','--') # 0105573-0354
REPLACE('010--5573-0354','--','/') # 010/5573-0354
TRANSLATE : 1:1 매핑되는 글자 치환
TRANSLATE('ORACLE','ABC','123') # OR13LE
문자 반올림/버림
ROUND : 지정된 자릿수까지 반올림
ROUND(150.774,1) # 150.8
ROUND(150.756,-2) # 200
ROUND(SYSDATE,'MM') # 16일 이상이면 다음달 1일
ROUND(SYSDATE,'HH') # 30초,30분 이상이면 올림
TRUNC : 지정된 자릿수까지 남기고 버림
TRUNC(150.534,1) # 150.5
TRUNC(150,535,-2) # 100
숫자 함수
FLOOR(3.8) # 3
CEIL(3.4) # 4
MOD(10,3) # 1
SIGN(-100) # -1 (양/음 판별)
NULL 처리 기본
NVL(값1,값2) : 값1이 NULL이면 값2로 대체
NVL('A',NULL) # 'A'
NVL(NULL,0) # 0
NVL2(값1,값2,값3) : 값1이 NULL이 아니면 값2를, NULL이면 값3을 반환
NULL 처리 확장
기본 배송지를 확인했는데 NULL이면 회사주소로, 회사주소도 없다면 최근배송지로 가정
COALESCE(기본배송지, 회사주소, 최근배송지)
예외처리 : COALESCE(기본배송지,회사주소,최근배송지,'주소없음')
같은말 : NVL(기본배송지,NVL(회사주소,최근배송지))
NULL 처리 응용
NULLIF : null -> 값
두 데이터가 같으면 NULL로 변경 (조건부 삭제)
IFNULL : 값 -> null
데이터가 NULL일 때 지정한 값으로 대체
💡 ORACLE : NVL , MS-SQL : IFNULL, SQL-SERVER : ISNULL
날짜 확인
SYSDATE
TO_DATE(SYSDATE)
-> 2025-11-11 00:00:00.000
TO_CHAR(SYSDATE)
-> 25/11/11
TO_CHAR(SYSDATE,'YYYYMMDD')
-> ERROR !
TO_DATE(SYSDATE,'YYYYMMDD') # 계산이 가능한 '진짜 날짜'로 변환
TO_DATE(SYSDATE,'YYYYMMDD HH24:MI:SS')
-> 20251106 1921141
날짜 계산
TO_DATE('20251106','YYYYMMDD') + 1/24/60
-> 1/24 : 1시간
-> 1/24/60 : 1분
날짜 형식화 및 추출
DATE_FORMAT : 날짜를 문자열로 변환
EXTRACT : 날짜에서 숫자를 추출
EXTRACT(MONTH FROM 날짜)
-> 11 (현재 월)
EXTRACT(HOUR FROM sysdate)
-> ERROR! (ORACLE은 데이트 타입은 년월일 정보만 변환)
조건문
DECODE
DECODE(컬럼,비교1,결과1,비교2,결과2,...,기본결과)
'=' 비교만 가능
CASE
CASE 값 WHEN 조건1 THEN 결과1
WHEN 조건2 THEN 결과2...
ELSE 기본결과 END
SQL JOIN 정리
1.INNER JOIN
양쪽 테이블 모두에 공통으로 존재하는 ID만 결합
SELECT A.ID, A.이름, B.상품명
FROM Table_A A
INNER JOIN Table_B B ON A.ID = B.ID;
| 이름 | 상품명 |
|---|---|
| 김철수 | 노트북 |
| 이영희 | 스마트폰 |
| 박민수 | 공백 |
| 공백 | 모니터 |
결과
| 이름 | 상품명 |
|---|---|
| 김철수 | 노트북 |
| 이영희 | 스마트폰 |
2.LEFT OUTER JOIN
왼쪽 테이블(Table A)을 기준으로 전체를 출력하고, 오른쪽(Table B)에 매칭 데이터가 없으면 NULL을 채움.
SELECT A.ID, A.이름, B.상품명
FROM Table_A A
LEFT JOIN Table_B B ON A.ID = B.ID;
| 이름 | 상품명 |
|---|---|
| 김철수 | 노트북 |
| 이영희 | 스마트폰 |
| 박민수 | 공백 |
결과
| 이름 | 상품명 |
|---|---|
| 김철수 | 노트북 |
| 이영희 | 스마트폰 |
| 박민수 | NULL |
3.RIGHT OUTER JOIN
오른쪽 테이블(Table B)을 기준으로 전체를 출력하고, 왼쪽(Table A)에 매칭 데이터가 없으면 NULL을 채움.
SELECT B.ID, A.이름, B.상품명
FROM Table_A A
RIGHT JOIN Table_B B ON A.ID = B.ID;
| 이름 | 상품명 |
|---|---|
| 김철수 | 노트북 |
| 이영희 | 스마트폰 |
| 공백 | 모니터 |
결과
| 이름 | 상품명 |
|---|---|
| 김철수 | 노트북 |
| 이영희 | 스마트폰 |
| NULL | 모니터 |
4.FULL OUTER JOIN (합집합)
양쪽 테이블의 모든 행을 출력하며, 서로 매칭되지 않는 부분은 양쪽 모두 NULL로 채움.
SELECT COALESCE(A.ID, B.ID) AS ID, A.이름, B.상품명
FROM Table_A A
FULL OUTER JOIN Table_B B ON A.ID = B.ID;
| 이름 | 상품명 |
|---|---|
| 김철수 | 공백 |
| 이영희 | 스마트폰 |
| 공백 | 모니터 |
결과
| 이름 | 상품명 |
|---|---|
| 김철수 | NULL |
| 이영희 | 스마트폰 |
| NULL | 모니터 |
5.CROSS JOIN(카티시안 곱)
조건 없이 두 테이블의 모든 행을 1:1로 조합 (2x2 = 4)
| 이름 | 상품명 |
|---|---|
| 김철수 | 핸드폰 |
| 이영희 | 모니터 |
결과
| 이름 | 상품명 |
|---|---|
| 김철수 | 핸드폰 |
| 김철수 | 모니터 |
| 이영희 | 핸드폰 |
| 이영희 | 모니터 |
UNION
1.UNION ALL (중복 허용 / 단순 결합)
두 결과 집합을 단순히 세로로 이어 붙임. 중복 제거 연산이 없어 속도가 빠름.
SELECT 이름, 금액 FROM Table_A
UNION ALL
SELECT 이름, 금액 FROM Table_B;
TABLE A
| 이름 | 금액 |
|---|---|
| 김철수 | 100 |
| 이영희 | 200 |
TABLE B
| 이름 | 금액 |
|---|---|
| 설영우 | 100 |
| 홍명보 | 400 |
결과
| 이름 | 금액 |
|---|---|
| 설영우 | 100 |
| 홍명보 | 400 |
| 김철수 | 100 |
| 이영희 | 200 |
2.UNION (중복 제거)
두 결과 집합을 합친 후 중복된 행을 제거. 중복 제거를 위해 정렬/해시 작업이 수행되므로 UNION ALL보다 상대적으로 느림.
SELECT 이름, 금액 FROM Table_A
UNION
SELECT 이름, 금액 FROM Table_B;
- UNION 사용 필수 규칙
- 조회하는 컬럼 수가 모든 SELECT 문에서 동일해야 함
- 대응하는 컬럼의 데이터 타입이 상호 호환되어야 함
- ORDER BY 구문은 맨 마지막 SELECT 문 뒤에만 1회 작성 가능
댓글 2
종훈 김 · 2026-08-19
💡 SUBSTR( INSTR('DATABASE','T'),3) # -> 💡 SUBSTR('DATABASE,INSTR('DATABASE','T'),3) #TAB
종훈 김 · 2026-08-19
ROUND(150.756,-2) # 120 - > ROUND(150.756,-2) # 200
로그인 후 댓글을 남길 수 있어요